Come Google e le AI leggono un sito web nel 2026: guida pratica
Come Google, ChatGPT, Perplexity e Gemini leggono un sito: crawling, JavaScript, dati strutturati, robots.txt e llms.txt, con cosa fare in pratica.
NoventraAggiornato il 7 min di lettura
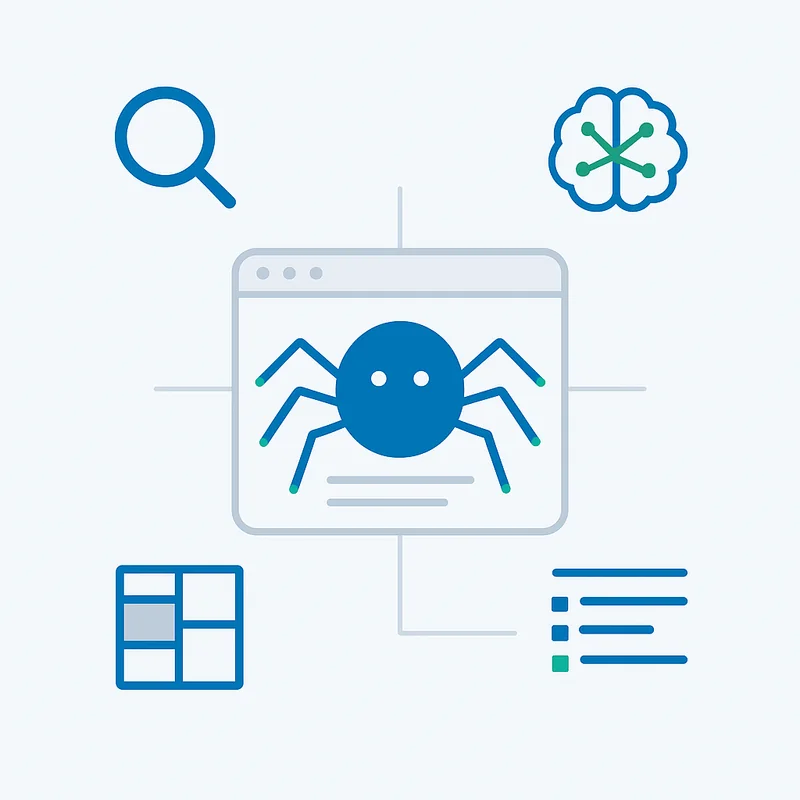
Google e gli assistenti AI leggono un sito in tre passaggi: un crawler scarica le pagine, un sistema le interpreta (testo, struttura, dati strutturati) e poi le usa per posizionarle o citarle nelle risposte. Per farti leggere bene servono pagine raggiungibili, contenuto visibile nell’HTML, struttura chiara e passaggi che rispondono a una domanda in modo autonomo.
Come legge un sito Google?
Google lavora in tre fasi, ed è utile tenerle separate perché i problemi nascono in punti diversi:
- Scansione (crawling): Googlebot segue i link e le sitemap e scarica le pagine.
- Rendering: Googlebot esegue il JavaScript con una versione recente di Chromium e vede la pagina completata, anche se con ritardo rispetto al primo scaricamento.
- Indicizzazione e ranking: Google capisce di cosa parla la pagina, la inserisce nell’indice e decide quando mostrarla.
Una pagina bloccata da robots.txt non viene scansionata, una con tag noindex non viene indicizzata, una il cui testo compare solo dopo azioni dell’utente può non essere vista. I panorami AI di Google (come le risposte generate in cima alla ricerca) si appoggiano alla stessa base: per comparire, la pagina deve essere indicizzata e idonea a essere mostrata.
Come leggono un sito ChatGPT, Perplexity e Gemini?
Gli assistenti AI attingono a due fonti: ciò che il modello ha imparato in addestramento e ciò che recupera in tempo reale quando cerca sul web. Il secondo caso è quello su cui puoi intervenire.
Ogni piattaforma usa propri crawler, con nomi dichiarati nella documentazione pubblica:
| Piattaforma | Crawler | Uso principale |
|---|---|---|
| OpenAI | GPTBot | Raccolta per l’addestramento |
| OpenAI | OAI-SearchBot | Ricerca in ChatGPT |
| OpenAI | ChatGPT-User | Visite su richiesta dell’utente |
| Perplexity | PerplexityBot | Indicizzazione per la ricerca |
| Googlebot, con Google-Extended come controllo | Ricerca; Google-Extended gestisce l’uso per i modelli Gemini | |
| Anthropic | ClaudeBot | Raccolta di contenuti web |
Alcune piattaforme usano anche indici di motori tradizionali, quindi essere ben indicizzato su Google e Bing resta una base utile. Le regole cambiano spesso: verifica i nomi aggiornati nella documentazione ufficiale di ciascuna.
Il JavaScript è un problema per le AI?
Può esserlo. Googlebot esegue JavaScript, ma molti altri crawler leggono soprattutto l’HTML ricevuto dal server e non eseguono script. Se il tuo sito mostra i contenuti solo dopo il caricamento lato browser, per questi crawler la pagina può risultare vuota o quasi.
Come ti accorgi del problema e come lo risolvi:
- Test rapido: apri la pagina, scegli “visualizza sorgente” e cerca un tuo titolo o paragrafo. Se non c’è, il crawler potrebbe non vederlo.
- Rendering lato server (SSR) o generazione statica (framework come Next.js o Astro): il testo arriva già nell’HTML.
- Prerendering per siti React o Vue esistenti.
- Contenuti essenziali nell’HTML: testo, titoli, link e prezzi non devono dipendere da script o da schede da cliccare.
Per un sito nuovo è la scelta tecnica più importante dopo il contenuto.
Che ruolo hanno i dati strutturati?
I dati strutturati Schema.org, in formato JSON-LD, dicono a macchine e motori cosa rappresenta una pagina: chi sei, che cos’è un articolo, quali sono le domande e risposte.
Quelli più utili per un sito aziendale:
- Organization o LocalBusiness: nome, logo, indirizzo, contatti, profili social.
- Article o BlogPosting: titolo, autore, date di pubblicazione e aggiornamento.
- FAQPage: domande e risposte presenti nella pagina.
- Product e Offer per gli e-commerce.
- BreadcrumbList: percorso di navigazione.
Il markup deve descrivere ciò che l’utente vede nella pagina. Non garantisce posizionamento né citazioni, ma riduce l’ambiguità e rende più facile associare il tuo marchio alle informazioni giuste.
Come si scrive un contenuto citabile?
Un assistente AI non cita un sito intero: cita un passaggio. Quel passaggio deve reggersi da solo.
- Risposta diretta in apertura: 40-70 parole che rispondono alla domanda principale.
- Titoli come domande reali (“Quanto costa…?”, “Come funziona…?”).
- Una sezione, un’idea: ogni blocco comprensibile anche senza il resto.
- Fatti concreti e verificabili: definizioni, passaggi, confronti, tabelle, con fonti per dati e norme.
- Autore e data visibili, e un chiaro legame con l’azienda.
- Terminologia coerente: usa lo stesso nome per prodotti e servizi, ovunque.
Se un testo è vago, un modello ha poco da citare. Se è preciso, ha una frase pronta da riportare.
Come gestire robots.txt per i bot AI?
Il file robots.txt dice ai crawler quali parti del sito possono scansionare. Ogni crawler ha un nome, e puoi permettere o bloccare ciascuno in modo diverso.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /riservato/

User-agent: *
Disallow: /admin/
Prima di bloccare un bot, chiediti cosa vuoi ottenere. Bloccare i crawler di addestramento non è lo stesso che bloccare quelli di ricerca: i primi riguardano l’uso dei tuoi contenuti per addestrare i modelli, i secondi influenzano la possibilità di essere trovato nelle risposte. Se vuoi essere citato, non bloccare per errore quelli di ricerca. Controlla anche che firewall e protezioni anti-bot non li respingano senza che tu lo sappia.
Cos’è llms.txt e serve davvero?
llms.txt è una proposta pubblicata nel 2024: un file Markdown nella radice del sito che elenca le pagine più utili con una breve descrizione, pensato per essere letto da modelli linguistici.
Va detto con onestà: è una proposta, non uno standard adottato da tutti. Non risulta che le grandi piattaforme abbiano dichiarato di basarsi su questo file per scegliere cosa citare. Aggiungerlo costa poco e non fa danni, ma non va trattato come scorciatoia. Il tuo tempo rende di più su contenuto accessibile, struttura chiara e dati strutturati corretti.
Cosa fare in pratica
Una sequenza da seguire in ordine:
- Accessibilità: robots.txt, sitemap, nessun noindex per errore, pagine che rispondono con codice 200.
- HTML leggibile: testo essenziale presente nel sorgente, rendering lato server dove serve.
- Dati strutturati corretti e coerenti con la pagina.
- Contenuti: risposta diretta, titoli-domanda, FAQ, autore, data, fonti.
- Reputazione: menzioni e recensioni su fonti affidabili, profili coerenti, pagina “chi siamo” chiara.
- Verifica: fai le domande dei tuoi clienti a ChatGPT, Perplexity e Gemini ogni mese, annota se e come compari, e confronta con Search Console.
Se Google ti posiziona ma gli assistenti AI non ti citano, ne parliamo nella guida su perché ChatGPT non cita il tuo sito.
Come lavoriamo noi
Noventra segue sia la SEO tradizionale sia la visibilità negli assistenti AI. Ti descriviamo il metodo nella pagina sul servizio GEO e in quella su SEO e ottimizzazione. Partiamo da un controllo di accessibilità, rendering e contenuti, e ti diciamo cosa correggere per primo.
Vuoi capire come vede il tuo sito Google e come lo vedono gli assistenti AI? Raccontaci il tuo progetto: consulenza gratuita senza impegno.
Domande frequenti
Il mio sito può comparire nelle risposte di ChatGPT?
Sì, se le sue pagine sono accessibili ai crawler, il contenuto è leggibile nell’HTML e le informazioni sono chiare e affidabili. Nessuno può garantire una citazione, perché dipende dalla domanda e dalle fonti disponibili.
I crawler AI eseguono il JavaScript?
Googlebot lo esegue. Molti altri crawler leggono soprattutto l’HTML ricevuto e possono non vedere ciò che si genera nel browser. Per questo conviene avere il contenuto essenziale già nell’HTML, con rendering lato server o generazione statica.
Devo bloccare GPTBot e gli altri bot AI?
Dipende dai tuoi obiettivi. Se non vuoi che i tuoi contenuti servano per l’addestramento, puoi bloccare i crawler dedicati; se vuoi essere trovato nelle risposte, lascia accessibili quelli di ricerca. Valuta ogni bot separatamente.
llms.txt migliora le citazioni?
Non ci sono prove ufficiali che lo faccia: è una proposta non supportata da tutti i motori e assistenti. Puoi aggiungerlo senza rischi, ma dai priorità a contenuti, struttura e accessibilità.
I dati strutturati bastano per farmi citare?
No. Aiutano a far capire cosa contiene la pagina, ma contano anche qualità del testo, reputazione del marchio e pertinenza rispetto alla domanda. Usali come supporto, non come soluzione unica.
Continua a leggere
SEO Locale a Napoli: guida pratica per aziende e professionisti nel 2026
SEO locale a Napoli: cosa fare su Google Business Profile, recensioni, pagine locali e citazioni per farti trovare, con una checklist di 30 giorni.
Marketing per le aziende: perché serve e da dove iniziare
Marketing per le aziende: obiettivi, pubblico, canali e metriche che contano davvero, con un metodo per decidere il budget e partire in piccolo.
Migliori web agency a Napoli: come scegliere la tua (guida 2026)
Come scegliere una web agency a Napoli: 7 criteri che puoi verificare prima di firmare, costi reali per sito, e-commerce e web app, e le domande da fare a qualsiasi agenzia.