Guida all’architettura software scalabile
Un gestionale che rallenta durante la chiusura mensile, un e-commerce che cede al picco promozionale o un CRM che non regge l’aumento degli utenti non hanno quasi mai un solo problema. Sono il risultato di decisioni architetturali rimandate, spesso comprensibili all’inizio del progetto ma costose quando il sistema cresce. Questa guida all’architettura software scalabile chiarisce quali scelte contano davvero per costruire applicazioni che possano evolvere senza compromettere operatività, sicurezza e controllo dei costi.
Scalabilità non significa preparare una piattaforma per milioni di utenti che non arriveranno mai. Per una PMI significa saper assorbire una crescita prevedibile o improvvisa - più ordini, sedi, utenti, integrazioni e dati - mantenendo tempi di risposta accettabili e senza dover riscrivere tutto.
Cosa rende scalabile un’architettura software
Un sistema è scalabile quando può aumentare la propria capacità in modo misurabile e controllato. La capacità non riguarda solo il numero di accessi simultanei: può riguardare l’elaborazione di documenti, la sincronizzazione con un ERP, l’importazione di cataloghi prodotto, l’invio di comunicazioni o le ricerche su grandi archivi.
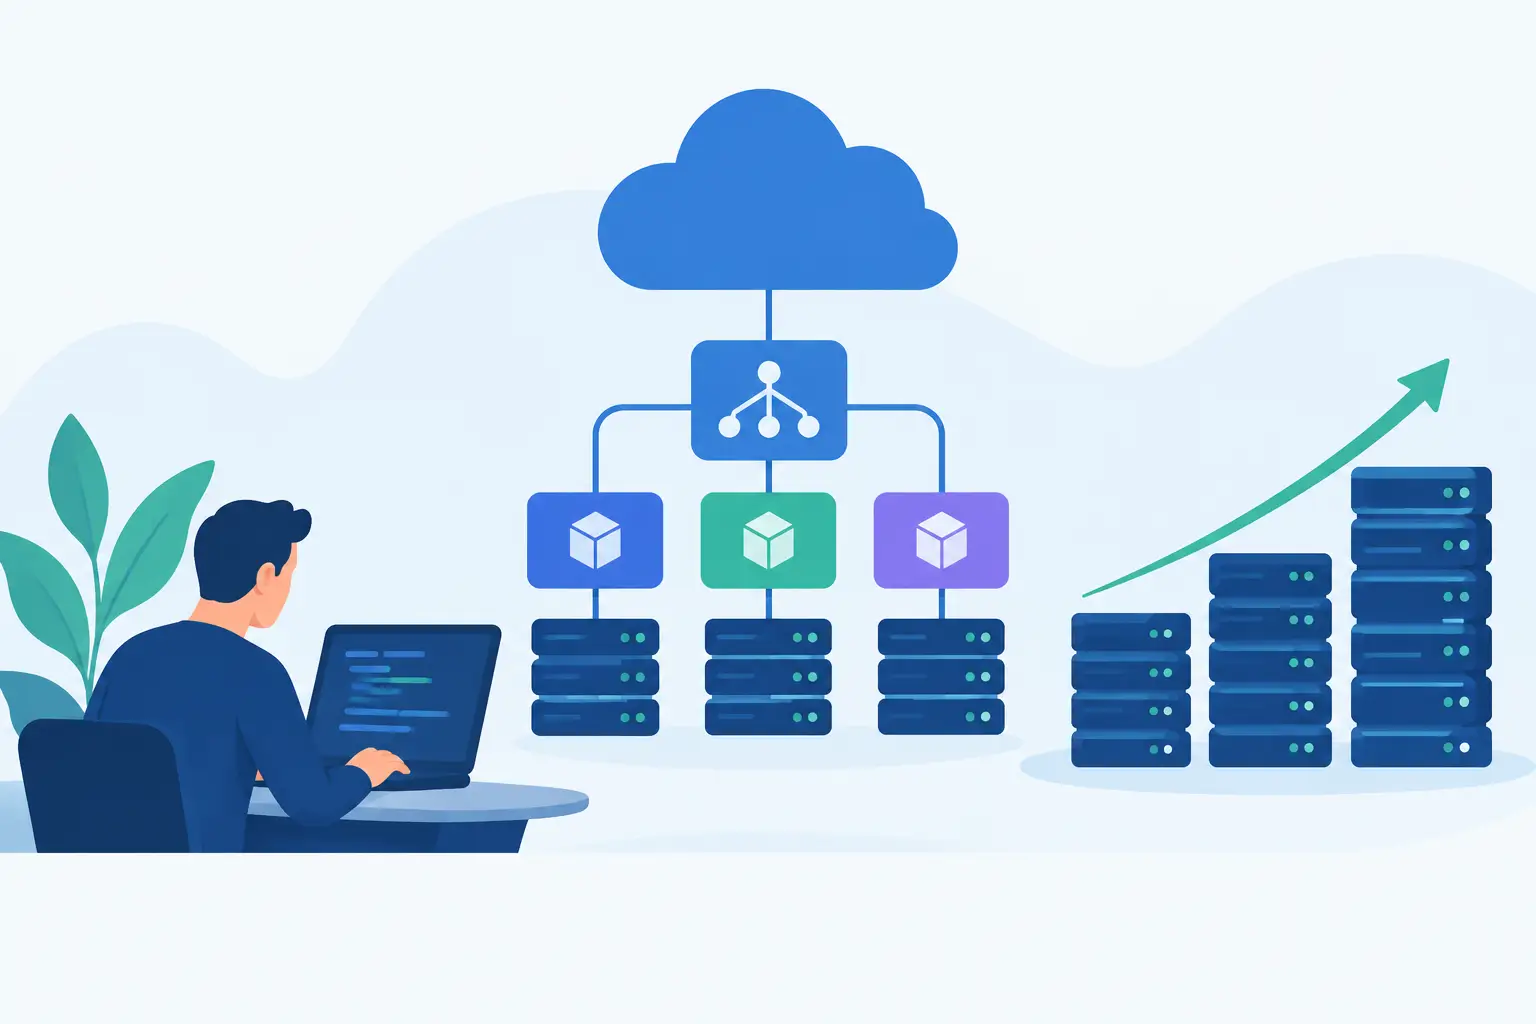
La prima distinzione utile è tra scalabilità verticale e orizzontale. La scalabilità verticale consiste nell’aumentare le risorse di una singola macchina: più CPU, RAM o disco. È rapida da attuare e spesso è la scelta corretta nelle prime fasi. Ha però un limite fisico ed economico, oltre a lasciare un possibile punto singolo di guasto.
La scalabilità orizzontale distribuisce invece il carico su più istanze dell’applicazione o su servizi separati. Richiede maggiore disciplina tecnica: sessioni, file temporanei, code e cache non possono dipendere da un singolo server. In cambio, consente di aumentare la capacità in modo più graduale e di ridurre l’impatto di un guasto isolato.
Non è necessario scegliere un modello puro. Molte applicazioni Laravel, Node.js o basate su React iniziano con una buona configurazione verticale e introducono componenti distribuiti solo quando i dati di utilizzo dimostrano che servono. Il criterio non è la complessità tecnica, ma il costo di un rallentamento o di un fermo per il business.
Guida architettura software scalabile: partire dai carichi reali
Prima di definire server, database o servizi cloud, occorre descrivere i flussi critici. Quanti utenti lavorano contemporaneamente? In quali fasce orarie? Quali operazioni generano più letture, scritture o calcoli? Quale indisponibilità è tollerabile per ciascuna funzione?
Un portale B2B, per esempio, può avere pochi utenti ma query molto pesanti, listini personalizzati e sincronizzazioni frequenti. Un e-commerce può affrontare picchi brevi ma intensi durante campagne e saldi. Una piattaforma SaaS può richiedere isolamento dei dati tra clienti, audit delle operazioni e processi automatici continui. Chiamare tutto questo semplicemente “traffico” porta a progettare male.
Conviene tradurre i requisiti in obiettivi verificabili: tempo massimo di risposta per le pagine principali, numero di ordini processabili all’ora, finestra di ripristino accettabile e quantità di dati gestibile nei prossimi 12-24 mesi. Questi parametri orientano le decisioni e rendono possibile capire, dopo il rilascio, se il sistema sta rispettando le attese.
Separare responsabilità, non moltiplicare servizi
Un’applicazione monolitica ben progettata non è un errore. Per molti progetti è più semplice da distribuire, osservare e mantenere rispetto a un insieme di microservizi. Il problema nasce quando logiche non correlate sono intrecciate nello stesso codice, nello stesso database e nello stesso processo di rilascio.
La separazione utile è quella delle responsabilità. L’interfaccia utente, le regole di dominio, l’accesso ai dati, le integrazioni esterne e i lavori asincroni devono avere confini chiari. Questo consente di ottimizzare o sostituire una componente senza produrre effetti imprevedibili sulle altre.
I microservizi diventano sensati quando esistono domini realmente indipendenti, team in grado di gestirli e necessità di scalare parti diverse del sistema in modo autonomo. In caso contrario aumentano i costi di monitoraggio, deployment, sicurezza e gestione degli errori distribuiti. Spezzare un monolite senza una ragione operativa è spesso un modo più rapido per creare complessità.
Database, cache e code: dove si gioca la tenuta del sistema
Nella maggior parte delle applicazioni business, il database è il componente più sensibile. Una struttura dati coerente, indici progettati sulle query effettive e controlli sulle transazioni contano più di una scelta tecnologica fatta per moda. Una query lenta eseguita migliaia di volte può compromettere l’intera piattaforma anche con server dimensionati generosamente.
La crescita va pianificata distinguendo i dati operativi da quelli storici. Archivi, log, documenti e dati analitici non devono necessariamente gravare sulle stesse tabelle e sugli stessi processi che gestiscono un ordine o una pratica in tempo reale. Anche la retention va definita: conservare tutto nello stesso livello di storage aumenta costi e tempi di gestione.
La cache serve a ridurre letture ripetitive, non a nascondere difetti strutturali. È utile per configurazioni, cataloghi, risultati costosi o contenuti pubblici; è meno adatta a informazioni che devono essere aggiornate all’istante senza una strategia precisa di invalidazione. Una cache non governata produce dati incoerenti, uno dei problemi più difficili da diagnosticare lato utente.
Le code di elaborazione separano le attività lente dalla richiesta dell’utente. Invio email, generazione PDF, importazioni, aggiornamenti di magazzino, elaborazione immagini e chiamate a servizi esterni dovrebbero essere eseguiti da worker dedicati quando non è necessario attendere il risultato in pagina. Per funzionare bene, ogni job deve poter essere ripetuto senza duplicare effetti e deve gestire errori, tentativi e notifiche.
Infrastruttura scalabile significa anche ripristinabile
Un’architettura non è scalabile se cresce senza poter essere ricostruita. Configurazioni manuali dei server, credenziali distribuite senza controllo e procedure di deploy non ripetibili trasformano ogni intervento in un rischio operativo.
Container Docker, configurazioni versionate e pipeline di rilascio consentono di rendere l’ambiente prevedibile. Nginx può distribuire le richieste tra più istanze applicative; un bilanciatore può verificare lo stato dei nodi ed escludere quelli non disponibili. Ma l’alta disponibilità ha senso solo se database, storage, code e dipendenze esterne sono considerati nello stesso disegno.
Backup e disaster recovery meritano una verifica pratica, non una casella spuntata in un documento. Un backup esiste davvero solo se può essere ripristinato entro il tempo richiesto dall’azienda. Occorre stabilire con chiarezza quali dati vengono salvati, con quale frequenza, dove sono conservati, chi può accedervi e come viene testato il recupero.
Sicurezza e osservabilità non sono componenti aggiuntivi
Più un sistema diventa distribuito, più aumentano i punti da proteggere. Segreti applicativi, accessi amministrativi, API, dipendenze software, permessi sul database e regole di rete devono essere gestiti con il principio del privilegio minimo. La sicurezza applicativa include validazione degli input, gestione delle sessioni, aggiornamenti e protezione contro le vulnerabilità note; quella infrastrutturale riguarda anche isolamento, accessi, log e procedure di risposta agli incidenti.
Allo stesso modo, non si può migliorare ciò che non si misura. Log centralizzati, metriche su CPU, memoria, errori applicativi, tempi delle query e stato delle code permettono di intervenire prima che un rallentamento diventi un blocco. Gli alert devono essere pochi ma utili: segnalazioni continue e senza priorità finiscono per essere ignorate.
Per i sistemi che gestiscono processi aziendali critici, vale la pena tracciare anche indicatori funzionali: ordini non sincronizzati, fatture in errore, job bloccati, integrazioni che superano una certa soglia di ritardo. Sono spesso più rilevanti di un semplice dato di utilizzo del server.
Progettare per cambiare senza fermare il business
La crescita porta modifiche: nuovi canali di vendita, sedi, ruoli, listini, obblighi normativi e integrazioni. Un’architettura scalabile deve rendere queste modifiche gestibili. API documentate, migrazioni del database reversibili, feature flag e rilasci progressivi riducono il rischio di introdurre regressioni.
Anche la compatibilità con sistemi terzi va trattata come un punto critico. ERP, gateway di pagamento, corrieri e servizi fiscali possono rispondere lentamente, cambiare regole o non essere disponibili. Le integrazioni devono prevedere timeout, retry controllati, code e strumenti di riconciliazione. Affidarsi a una chiamata sincrona senza gestione dell’errore significa trasferire all’utente finale l’instabilità di un sistema esterno.
Per un’impresa, la scelta migliore raramente è l’architettura più sofisticata. È quella che sostiene il carico previsto, espone i rischi, può essere mantenuta da un team competente e permette di investire dove serve. Il passo utile è partire dai flussi che oggi rallentano il lavoro o mettono a rischio la continuità: sono loro a indicare quale evoluzione architetturale ha davvero priorità.