Guida gestione incidenti informatici per PMI
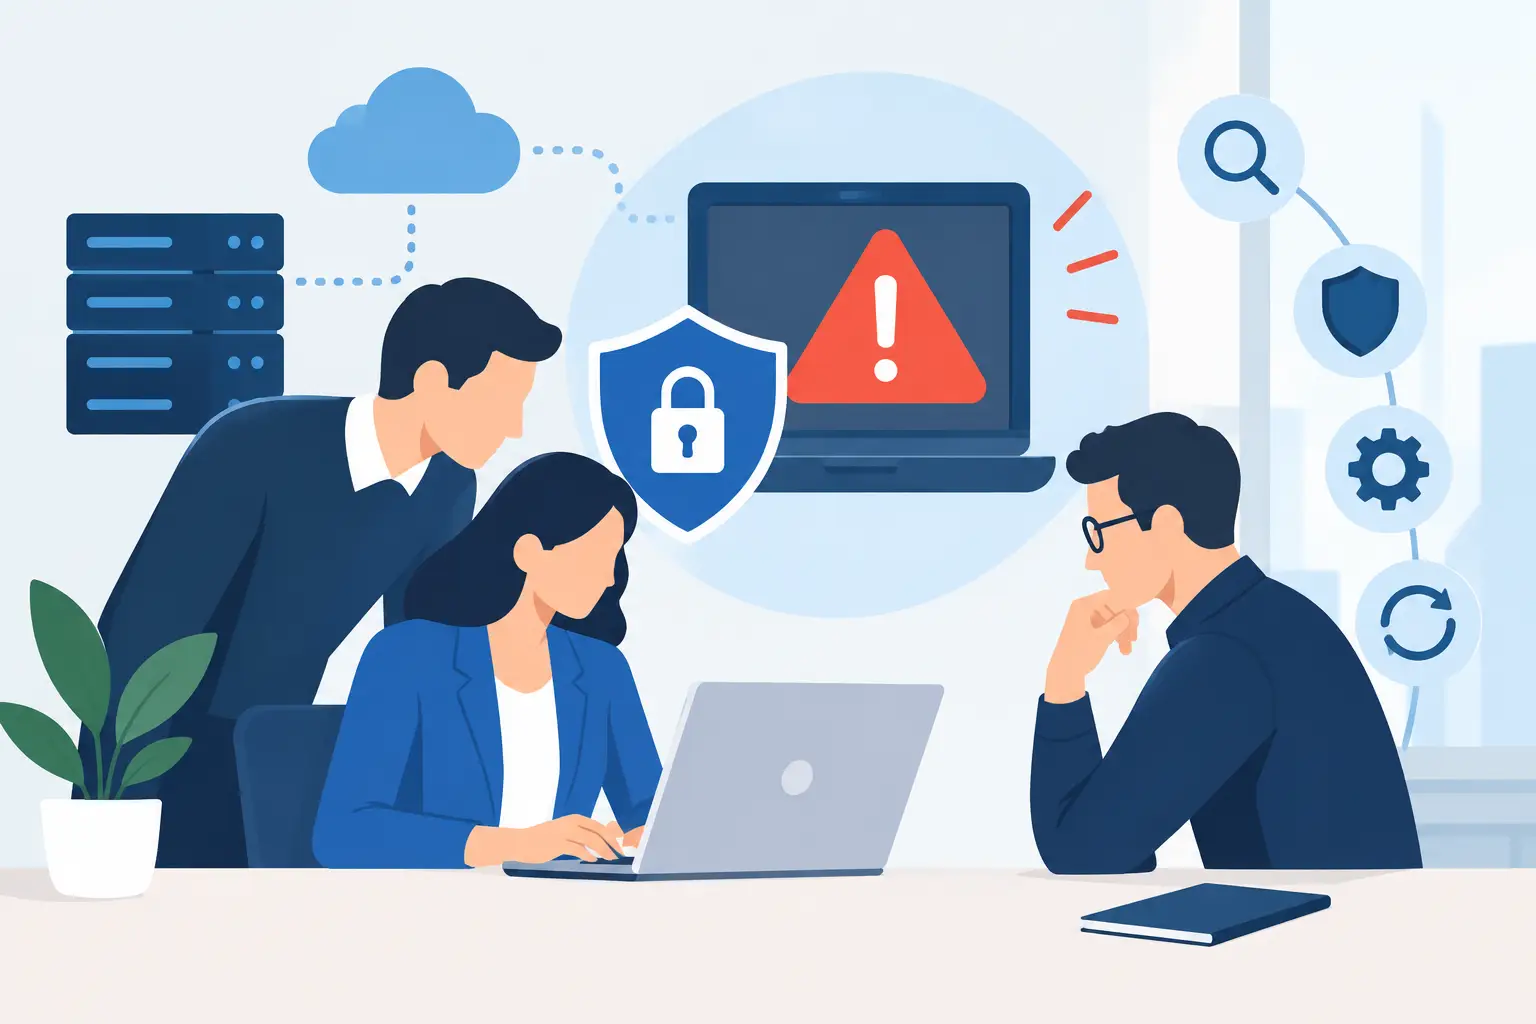
Un account amministrativo che accede da una località insolita, un e-commerce che inizia a reindirizzare gli utenti, un server che consuma risorse senza una ragione apparente: sono segnali che richiedono decisioni rapide, non discussioni astratte. Una guida gestione incidenti informatici serve proprio a questo: definire cosa fare nelle prime ore, chi può decidere e come riportare i sistemi in esercizio senza trasformare un problema tecnico in un fermo operativo prolungato.
Per una PMI, un incidente non riguarda soltanto il reparto IT. Può bloccare ordini, fatturazione, logistica, assistenza clienti e accesso ai dati. Se sono coinvolti dati personali, entrano in gioco anche obblighi di valutazione e notifica. La qualità della risposta dipende meno dal singolo strumento acquistato e più da procedure realistiche, accessi controllati e responsabilità già assegnate.
Quando un evento diventa un incidente
Non ogni anomalia è un attacco. Un picco di CPU può dipendere da una campagna commerciale, da un job pianificato male o da un errore applicativo. Un login fallito può essere un utente che ha dimenticato la password. Trattare ogni alert come una crisi paralizza il lavoro; ignorare gli indicatori rilevanti espone a danni maggiori.
Un evento diventa incidente quando compromette, o può ragionevolmente compromettere, riservatezza, integrità o disponibilità di sistemi e dati. Rientrano in questa categoria ransomware, malware, furto di credenziali, accessi amministrativi non autorizzati, defacement di siti, esfiltrazione di dati, vulnerabilità sfruttate e indisponibilità causate da attacchi DDoS.
La prima valutazione deve rispondere a tre domande: quale servizio è coinvolto, quali dati o processi sono esposti e l'attività è ancora in corso? Non serve avere subito tutte le risposte. Serve stabilire il livello di priorità e attivare il canale corretto.
Guida gestione incidenti informatici: ruoli prima dell'emergenza
La procedura più dettagliata fallisce se, alle 22 di venerdì, nessuno sa chi può disabilitare un account, spegnere un servizio o autorizzare una comunicazione ai clienti. Il piano deve indicare nomi, contatti alternativi, fasce di reperibilità e poteri decisionali.
In una struttura snella, i ruoli possono essere coperti dalle stesse persone, ma le responsabilità devono restare distinte. Il responsabile tecnico coordina analisi e interventi; chi conosce il processo aziendale valuta l'impatto operativo; direzione e referenti legali o privacy decidono le comunicazioni esterne quando necessarie. Se l'infrastruttura è affidata a un partner, il contratto deve definire tempi di presa in carico, accessi di emergenza e perimetro d'intervento.
È utile classificare gli incidenti in base all'impatto, non solo alla causa tecnica. Un problema su un ambiente di test richiede attenzione diversa da un blocco del gestionale di magazzino. Una scala semplice può prevedere priorità critica per servizi fermi o dati potenzialmente esfiltrati, alta per compromissioni contenute ma confermate, media per anomalie da verificare e bassa per eventi senza impatto concreto.
Questa classificazione evita due errori frequenti: coinvolgere troppe persone su eventi minori e sottovalutare problemi che toccano processi essenziali.
Le prime ore: contenere senza distruggere le prove
Il contenimento ha un obiettivo chiaro: limitare la propagazione e impedire all'attaccante di mantenere accesso. Non coincide sempre con lo spegnimento immediato del server. Spegnere una macchina compromessa può interrompere un ransomware in corso, ma può anche cancellare evidenze utili dall'analisi della memoria o rendere più difficile capire il vettore d'ingresso.
La scelta dipende dal rischio immediato. Se un server mostra attività di cifratura, connessioni sospette verso l'esterno o movimenti laterali, l'isolamento dalla rete è normalmente prioritario. Se invece l'evento riguarda un account SaaS, la prima azione può essere revocare sessioni, disabilitare l'utente, reimpostare le credenziali e verificare le regole di inoltro della posta.
Durante questa fase, il team dovrebbe registrare orari, sistemi coinvolti, azioni eseguite e motivazioni. È una disciplina semplice, ma decisiva. Senza una timeline è facile sovrascrivere informazioni, duplicare interventi o non riuscire a ricostruire cosa sia accaduto.
Le azioni iniziali più comuni comprendono l'isolamento dell'asset, la sospensione degli account sospetti, la rotazione delle credenziali privilegiate, il blocco di indicatori noti su firewall e DNS e la verifica di backup non raggiungibili dalla rete compromessa. Nessuna di queste azioni va applicata automaticamente a ogni scenario: bloccare un indirizzo IP, ad esempio, è poco utile se il problema nasce da credenziali valide già rubate.
Preservare log e configurazioni
Log di sistema, accessi VPN, audit cloud, eventi del firewall, log applicativi e cronologia delle modifiche sono spesso l'unica fonte per ricostruire l'incidente. Devono essere esportati o messi al sicuro prima che le normali politiche di rotazione li eliminino.
Anche le configurazioni contano. Una modifica a Nginx, una chiave API esposta, un container avviato fuori pipeline o un utente aggiunto al pannello di controllo possono spiegare più di un antivirus che non rileva nulla. Per applicazioni Laravel, Node.js o piattaforme e-commerce, vanno controllati file modificati, dipendenze, account di back office, webhook, chiavi di integrazione e attività amministrative recenti.
Eradicare la causa, non solo il sintomo
Un ripristino frettoloso può riportare online lo stesso problema. Rimuovere un file malevolo senza correggere la vulnerabilità sfruttata, cambiare una password senza revocare token e sessioni, oppure ripristinare un backup già compromesso significa lasciare aperta la porta.
L'eradicazione parte dall'ipotesi più verificabile: come è entrato l'attaccante e quale persistenza ha lasciato? Le cause ricorrenti nelle PMI sono credenziali deboli o riutilizzate, mancata autenticazione a più fattori, software non aggiornato, permessi eccessivi, servizi esposti inutilmente, segreti presenti nel codice o in file di configurazione e backup non protetti.
Il lavoro richiede controllo su tutto lo stack. A livello applicativo vanno corretti bug, dipendenze vulnerabili e autorizzazioni. A livello infrastrutturale vanno verificati utenti, chiavi SSH, regole firewall, immagini Docker, processi pianificati, configurazioni del reverse proxy e aggiornamenti del sistema operativo. Affidarsi a fornitori separati per codice, server e sicurezza può rallentare l'analisi proprio quando ogni passaggio deve essere tracciabile.
Ripristinare con criteri di sicurezza e continuità
Ripristinare non significa semplicemente riaccendere ciò che era spento. Significa riportare online i servizi essenziali in una condizione verificata. Quando possibile, è preferibile ricostruire server e container da immagini affidabili, applicare configurazioni controllate e ripristinare solo dati validati, invece di intervenire direttamente su una macchina sospetta.
Prima della riapertura, occorre verificare che gli accessi privilegiati siano stati ruotati, che l'autenticazione a più fattori sia attiva dove applicabile, che le patch siano state applicate e che i log siano raccolti. Per un e-commerce, il controllo deve includere checkout, integrazioni di pagamento, account amministrativi, catalogo, ordini e collegamenti con ERP o corrieri. Per un gestionale, conta anche la coerenza dei dati importati e il recupero delle transazioni rimaste in stato incompleto.
I backup sono centrali, ma non bastano se non vengono provati. Un backup utile deve essere recente, leggibile, completo e separato dall'ambiente che può essere compromesso. La strategia dipende dai tempi di fermo tollerabili e dalla quantità di dati che l'azienda può accettare di perdere. Un'azienda che fattura migliaia di ordini al giorno ha requisiti diversi da un portale con aggiornamenti settimanali.
Comunicazione, privacy e decisioni documentate
Il silenzio prolungato genera confusione, ma comunicare dettagli non verificati può aggravare il danno. All'interno servono aggiornamenti brevi e cadenzati: cosa è successo, quali servizi sono coinvolti, quale misura è stata presa e quando arriverà il prossimo aggiornamento. Questo permette ai reparti operativi di attivare procedure alternative senza inventare versioni diverse dell'accaduto.
Se l'incidente coinvolge dati personali, il titolare del trattamento deve valutare natura, portata, conseguenze e misure adottate. In alcuni casi può essere necessaria una notifica all'autorità competente entro le tempistiche previste dalla normativa, e in altri una comunicazione agli interessati. La valutazione va svolta con figure privacy e legali, usando evidenze tecniche documentate. Non è un adempimento da rimandare alla fine dell'emergenza.
Dopo l'incidente: trasformare il caso in correzioni concrete
La chiusura tecnica non chiude il lavoro. Entro pochi giorni è opportuno condurre una revisione senza cercare colpevoli: sequenza degli eventi, causa iniziale, controlli che non hanno funzionato, decisioni efficaci, tempi di rilevazione e tempi di ripristino.
Il risultato deve diventare un piano con priorità, responsabili e scadenze. Può includere segmentazione di rete, revisione dei privilegi, gestione centralizzata delle patch, monitoraggio dei log, test di ripristino, formazione mirata contro phishing e aggiornamento della procedura di risposta. Meglio cinque interventi completati e verificati che venti raccomandazioni generiche lasciate in un verbale.
Noventra affronta questi scenari collegando sviluppo, infrastruttura e remediation: è il modo più diretto per capire se il punto debole è nel codice, nella configurazione o nel processo operativo.
Un piano di gestione incidenti è utile solo se viene provato. Simulare la compromissione di un account, il fermo di un database o il ripristino di un e-commerce rivela contatti obsoleti, accessi mancanti e backup inutilizzabili prima che lo faccia un attaccante. Il test più utile non è quello perfetto: è quello che mostra dove intervenire lunedì mattina.