Quali dati salvare nel backup della tua azienda
Un ripristino che riporta online solo una parte del sistema non è un ripristino riuscito. Se il gestionale torna operativo ma mancano gli allegati, se il sito è online ma il database è fermo a tre giorni prima, l'attività resta esposta. Decidere quali dati salvare nel backup significa quindi definire cosa serve davvero per riprendere a lavorare, non semplicemente copiare file su uno storage.
Per una PMI, il tema coinvolge applicazioni, infrastruttura, documenti, identità digitali e servizi SaaS. La difficoltà non è attivare un software di backup: è conoscere le dipendenze tra questi elementi, stabilire priorità e verificare che il recupero sia possibile nei tempi richiesti dal business.
Quali dati salvare nel backup: il criterio corretto
La domanda non dovrebbe essere «quanti dati possiamo salvare?», ma «cosa succede se questo dato non è disponibile domani mattina?». Un backup aziendale va progettato partendo dai processi operativi: fatturazione, ordini, produzione, assistenza clienti, e-commerce, gestione magazzino, farmacia o logistica hanno requisiti diversi.
Due parametri aiutano a trasformare questa valutazione in una scelta tecnica. Il primo è l'RPO, Recovery Point Objective: quanti dati l'azienda può accettare di perdere in caso di incidente. Se un e-commerce riceve ordini continuamente, un backup notturno può essere insufficiente. Il secondo è l'RTO, Recovery Time Objective: quanto tempo può trascorrere prima che il servizio debba tornare disponibile.
Non tutto richiede lo stesso RPO e lo stesso RTO. Applicare la medesima frequenza a ogni sistema aumenta costi e complessità senza necessariamente aumentare la protezione. Al contrario, classificare dati e servizi permette di concentrare risorse sulle componenti che fermano davvero l'operatività.
Le categorie di dati da includere
Database applicativi e gestionali
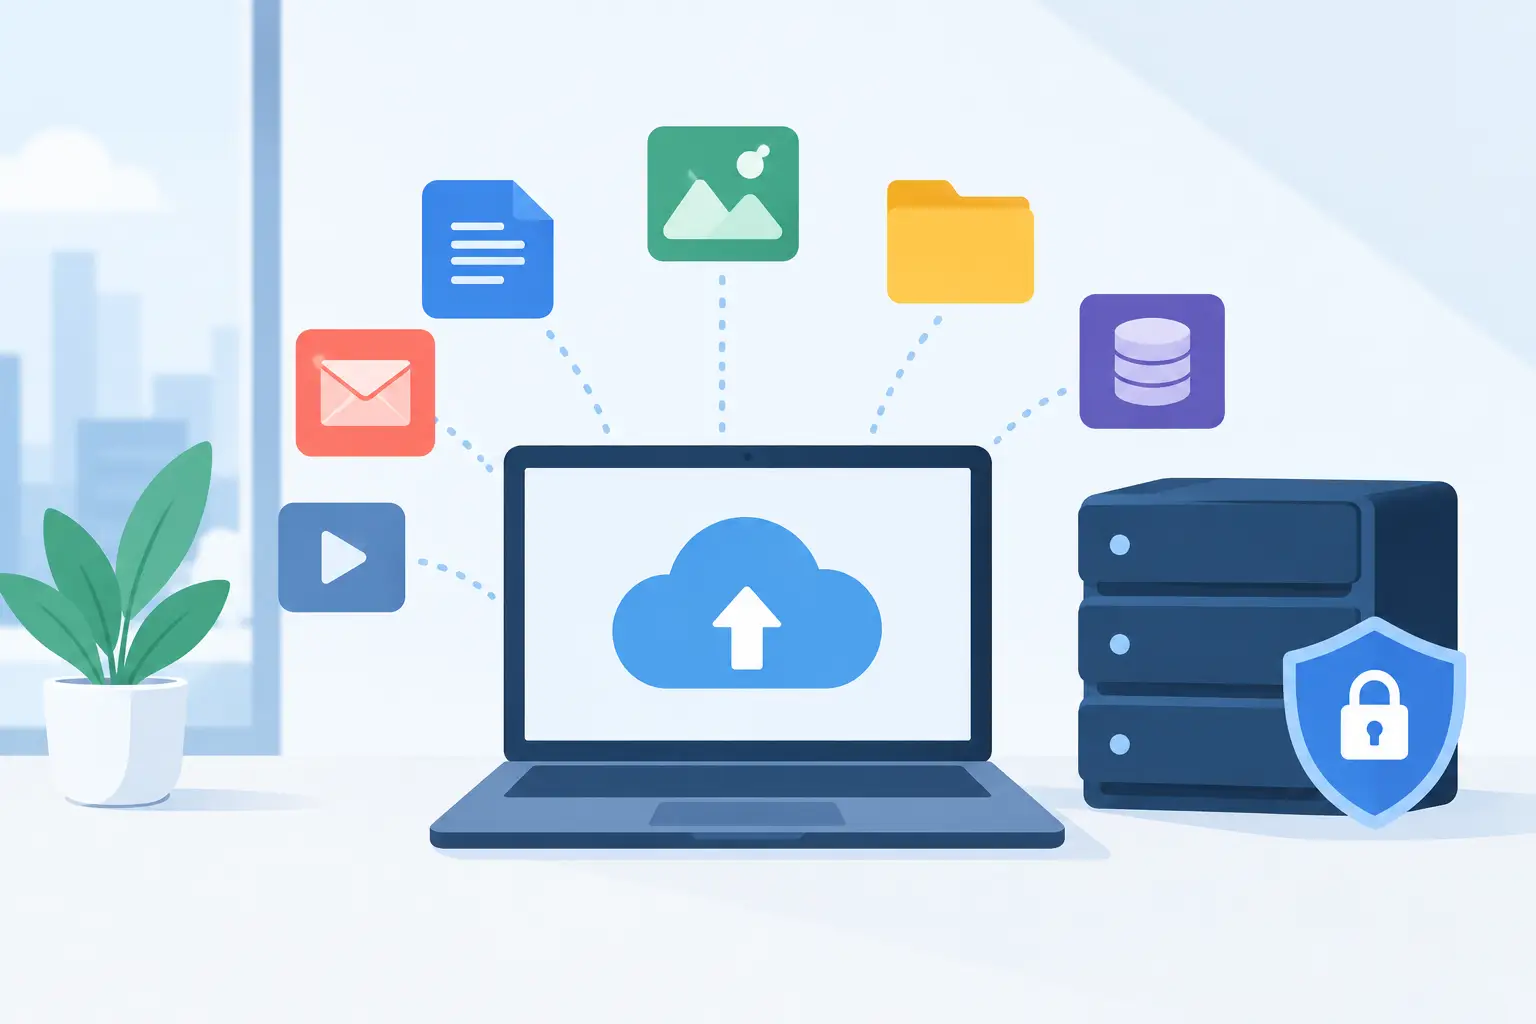
I database sono quasi sempre la prima priorità. Contengono anagrafiche clienti e fornitori, ordini, movimenti di magazzino, fatture, configurazioni applicative, ticket, cataloghi prodotti e stati dei processi. In molte applicazioni web, il codice può essere ridistribuito da un repository o da una pipeline, mentre i dati prodotti ogni giorno esistono solo nel database.
Non basta però esportare periodicamente una copia SQL. Occorre verificare coerenza, cifratura, tempi di ripristino e compatibilità con la versione del database in produzione. Per sistemi con transazioni frequenti possono servire backup incrementali, snapshot consistenti o replica, a seconda dell'RPO richiesto.
Documenti, allegati e file operativi
Contratti, DDT, preventivi, certificazioni, immagini prodotto, documentazione tecnica, scansioni e allegati caricati dai clienti non sono sempre nel database. Spesso risiedono in volumi Docker, file server, object storage o cartelle condivise. Se il database viene recuperato ma gli allegati no, l'applicazione può risultare formalmente funzionante ma inutilizzabile per gli utenti.
Va considerata anche la relazione tra file e record applicativi. Un backup eseguito in momenti diversi può creare disallineamenti: il database punta a un documento che nel backup non esiste ancora, oppure conserva riferimenti a file eliminati. Nei sistemi critici, la procedura deve garantire un punto di ripristino coerente.
Configurazioni, codice e componenti infrastrutturali
Un server non è solo il contenuto di un disco. Configurazioni Nginx, variabili d'ambiente, chiavi di cifratura, certificati, job schedulati, configurazioni DNS, regole firewall, file Compose, definizioni di container e script di deploy incidono direttamente sulla possibilità di rimettere in servizio un'applicazione.
Il codice sorgente dovrebbe essere gestito in un repository versionato e protetto con permessi adeguati, non affidato all'unica copia presente sul server. Lo stesso vale per l'infrastruttura: dove possibile, configurazioni e procedure di provisioning devono essere documentate e versionate. Un'immagine completa della VPS può accelerare il recupero, ma non sostituisce backup selettivi e configurazioni ricostruibili.
Posta, piattaforme cloud e strumenti SaaS
Molte aziende considerano protetti i dati perché risiedono in Microsoft 365, Google Workspace, CRM cloud, gestionali SaaS o piattaforme e-commerce. È un assunto rischioso. Il fornitore garantisce normalmente la disponibilità della propria piattaforma, non la possibilità di recuperare qualsiasi file cancellato, account compromesso o modifica errata secondo le esigenze del cliente.
Caselle e-mail, calendari, file condivisi, contatti, esportazioni CRM, dati di Shopify, WooCommerce o Magento e contenuti pubblicati su piattaforme esterne vanno valutati esplicitamente. Il metodo cambia da servizio a servizio: in alcuni casi esistono esportazioni o API, in altri è necessario uno strumento di backup dedicato. La scelta va verificata prima di un incidente, non quando serve recuperare un dato.
Identità, accessi e segreti tecnici
Credenziali amministrative, account di servizio, token API, certificati, chiavi SSH e codici di recupero MFA sono componenti sensibili. Non possono essere trattati come normali file allegati a un backup non cifrato. Tuttavia, perderli può rendere impossibile accedere a server, domini, servizi cloud e strumenti di ripristino.
La soluzione è adottare un sistema di gestione dei segreti con accessi nominativi, cifratura e procedure di recupero controllate. Anche le configurazioni delle identità - ruoli, gruppi, policy e account tecnici - meritano una documentazione aggiornata. Il backup protegge i dati, ma senza gli accessi corretti potrebbe non essere possibile usarli.
Cosa non ha senso copiare senza criterio
Salvare tutto indistintamente può sembrare prudente, ma produce archivi costosi, tempi di recupero lunghi e una falsa sensazione di sicurezza. Cache applicative, file temporanei, build rigenerabili, log ad alto volume e copie duplicate vanno inclusi solo se hanno un valore operativo, tecnico o normativo preciso.
I log sono un caso tipico. Non sono necessari per riavviare ogni applicazione, ma possono essere fondamentali dopo un attacco o un malfunzionamento. È utile separarli dai backup di disaster recovery e definire una retention specifica per sicurezza, audit e diagnosi. Lo stesso criterio vale per i dati storici: conservarli può essere obbligatorio o utile, ma non devono rallentare il ripristino dei sistemi essenziali.
Backup, retention e conformità non sono la stessa cosa
Un backup serve a recuperare dati dopo guasto, errore umano, attacco ransomware o aggiornamento fallito. La conservazione sostitutiva e gli obblighi fiscali hanno invece finalità e requisiti diversi. Confondere i due piani porta spesso a soluzioni che non soddisfano né la continuità operativa né gli adempimenti.
Anche la protezione dei dati personali richiede attenzione. Un backup può contenere dati clienti, dipendenti, informazioni sanitarie o documenti riservati. Servono cifratura in transito e a riposo, controllo degli accessi, tracciamento delle operazioni e tempi di conservazione coerenti con le policy aziendali. La cancellazione di un dato dalla produzione non implica sempre la sua eliminazione immediata da tutte le copie di sicurezza, ma questa eccezione deve essere governata e documentata.
La regola 3-2-1 resta utile, con una condizione
La regola 3-2-1 prevede almeno tre copie dei dati, su due supporti differenti, con una copia conservata fuori sede. Oggi è opportuno aggiungere almeno una copia immutabile o isolata, non modificabile da un attaccante che abbia compromesso l'ambiente principale.
Non è necessario adottare la stessa architettura per ogni dato. Per alcune PMI può essere sufficiente combinare backup locali rapidi e copie cifrate su storage remoto; per sistemi più esposti, con RTO ridotto, servono replica, snapshot frequenti e procedure di failover. Il punto non è accumulare copie: è evitare che un singolo evento, una singola credenziale compromessa o un singolo errore cancelli tutte le possibilità di recupero.
Il test di ripristino decide se il backup esiste davvero
Un job completato con esito positivo dice soltanto che il software ha concluso un'operazione. Non dimostra che il backup sia integro, che il database si avvii, che l'applicazione riconosca i file allegati o che le configurazioni siano sufficienti per ricreare l'ambiente.
I test devono simulare scenari realistici: recupero di un singolo file cancellato, ripristino di un database a una data precisa, riattivazione di un servizio su una nuova VPS, recupero dopo indisponibilità totale del server. Ogni verifica dovrebbe misurare tempo effettivo, dati recuperati, attività manuali richieste e punti di blocco.
Queste prove portano spesso alla luce problemi banali ma gravi: password non disponibili, backup salvati nello stesso ambiente da proteggere, spazio insufficiente, procedure affidate a una sola persona o dipendenze non documentate. Correggerli durante un test costa poco rispetto a farlo nel mezzo di un fermo operativo.
Un buon piano di backup non nasce da una checklist generica. Nasce dalla conoscenza dei processi aziendali, dei dati che li alimentano e dell'infrastruttura che li rende disponibili. La prossima verifica utile non è controllare se l'ultimo backup è verde: è chiedersi se, con le copie disponibili oggi, l'azienda potrebbe davvero ripartire domani.