Strumenti per il monitoraggio server nelle PMI
Gli strumenti di monitoraggio server aiutano le PMI a prevenire fermi, misurare prestazioni e agire prima di un guasto ai servizi chiave dell impresa.
Noventra7 min di lettura
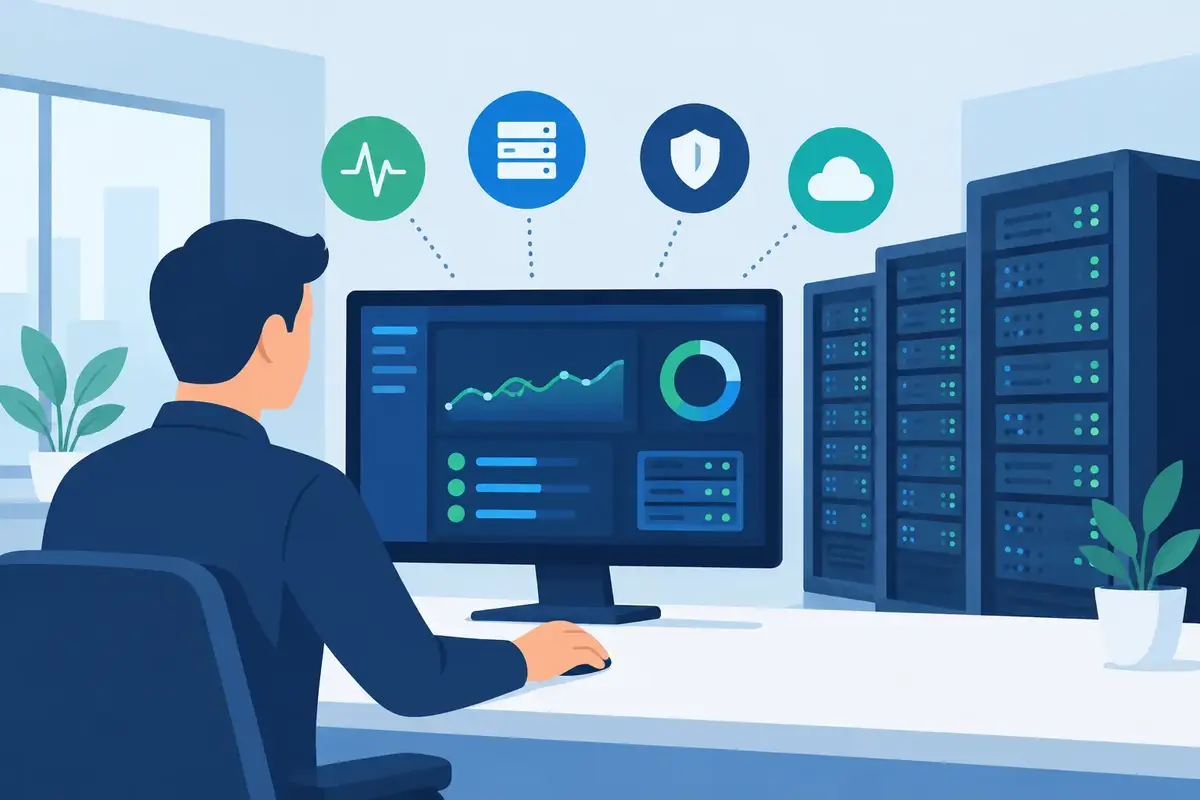
Un e-commerce che risponde con lentezza, un gestionale irraggiungibile alle 9 del mattino o un backup che non termina non sono semplici anomalie tecniche. Sono interruzioni operative, ordini persi, persone ferme. Gli strumenti di monitoraggio server servono a individuare questi segnali prima che diventino un problema per clienti e reparti interni.
Il punto non è installare una dashboard con molti grafici. Il punto è sapere quali componenti controllare, stabilire soglie coerenti con il servizio e fare in modo che l’allarme raggiunga qualcuno che possa intervenire. Senza questi tre elementi, il monitoraggio produce rumore invece di controllo.
Cosa deve monitorare davvero un’infrastruttura
Un server non è un’entità isolata. Ospita applicazioni, database, code, processi schedulati, servizi web e integrazioni esterne. Per questo limitarsi a verificare che una macchina sia accesa non basta: un server può rispondere al ping e, nello stesso momento, avere un database saturo o un’applicazione bloccata.
Il primo livello è l’infrastruttura. CPU, RAM, spazio disco, I/O, carico di sistema e traffico di rete indicano se le risorse sono adeguate e se esistono colli di bottiglia. Un disco al 90% non implica un fermo immediato, ma richiede attenzione: log, cache, backup e database possono crescere rapidamente e riempirlo nel momento meno opportuno.
Il secondo livello riguarda i servizi. Nginx deve rispondere sulle porte corrette, PHP-FPM o Node.js devono mantenere i processi attivi, MySQL o PostgreSQL devono accettare connessioni e i job in coda devono essere elaborati. Sono controlli più vicini alla continuità operativa rispetto alla sola telemetria del sistema operativo.
Il terzo livello è applicativo. Una richiesta HTTP con codice 200 non garantisce che un e-commerce consenta davvero di completare un ordine o che un gestionale visualizzi i dati corretti. Per i flussi critici conviene verificare endpoint specifici, tempi di risposta, esiti delle integrazioni e disponibilità di API, gateway di pagamento o servizi di spedizione.
Infine, occorre controllare ciò che spesso emerge solo dopo un incidente: backup eseguiti e verificabili, rinnovo dei certificati SSL, scadenza dei domini, stato delle repliche database e log di errore anomali. Sono elementi meno visibili, ma determinano quanto rapidamente un’azienda può ripartire.
Strumenti monitoraggio server: scegliere in base al contesto
Non esiste uno strumento migliore in assoluto. Esiste quello adeguato alla complessità dell’ambiente, alle competenze disponibili e al livello di intervento richiesto. Una PMI con una VPS e un’applicazione Laravel ha esigenze diverse da un’azienda con più ambienti Docker, e-commerce ad alto traffico e servizi distribuiti.
Zabbix per un presidio completo dell’infrastruttura
Zabbix è una scelta consolidata quando servono controlli estesi su server, servizi, rete e apparati. Attraverso agent installati sulle macchine oppure controlli remoti può raccogliere metriche, applicare trigger e inviare notifiche. È adatto a chi vuole una piattaforma centralizzata con storico, template e una buona capacità di personalizzazione.
Il vantaggio è la copertura: può monitorare una VPS, un cluster di macchine, switch, firewall, database e servizi applicativi. Il costo è una configurazione più articolata. Se trigger, dipendenze e soglie sono impostati senza criterio, si ricevono decine di alert poco utili e quelli importanti finiscono ignorati.
Prometheus e Grafana per metriche e ambienti containerizzati
Prometheus raccoglie metriche a intervalli regolari e si presta bene a infrastrutture dinamiche, soprattutto basate su Docker o orchestratori. Grafana completa il quadro con dashboard leggibili e analisi storiche. Insieme permettono di osservare l’andamento delle risorse, le prestazioni delle applicazioni e i tempi di risposta nel tempo.
Questa combinazione è particolarmente efficace quando sviluppo e operations devono leggere gli stessi dati. Un aumento degli errori 500 può essere confrontato con un deploy, un picco di richieste o l’esaurimento del pool di connessioni database. Richiede però metriche esposte correttamente dall’applicazione e una gestione attenta di retention, alerting ed exporter.
Netdata e controlli leggeri per visibilità immediata
Netdata offre una lettura molto rapida dello stato di una macchina, con molte metriche disponibili quasi subito dopo l’installazione. È utile durante analisi puntuali, in ambienti piccoli o come strumento complementare per approfondire cosa accade su un singolo nodo.
Per controlli di disponibilità semplici esistono anche soluzioni dedicate all’uptime e agli endpoint HTTP. Possono verificare che un sito o un’API siano raggiungibili da una posizione esterna. Sono utili, ma non sostituiscono il monitoraggio interno: sapere che una pagina è online non spiega perché il database rallenta o una coda di elaborazione cresce.
Gli alert devono essere azionabili
Un allarme efficace risponde a tre domande: cosa sta accadendo, qual è l’impatto e chi deve intervenire. Un messaggio come “CPU alta” è insufficiente se non indica su quale server, da quanto tempo e con quale soglia. Ancora peggio è notificare un picco momentaneo che si risolve da solo.
Le soglie vanno definite sul comportamento reale del servizio. Una CPU all’85% per pochi secondi durante una generazione report può essere fisiologica. La stessa CPU oltre l’85% per quindici minuti, insieme a tempi di risposta in crescita, è un segnale concreto. Anche lo spazio disco merita soglie progressive: un avviso preventivo consente di analizzare la causa, mentre un alert critico richiede un’azione immediata.
È utile distinguere gli avvisi informativi dagli incidenti. I primi possono alimentare report periodici o canali non urgenti; i secondi devono raggiungere il referente reperibile tramite i canali concordati. L’escalation deve essere chiara: se l’alert non viene preso in carico, deve passare a un secondo livello. Affidarsi a una casella email generica equivale spesso ad accorgersi del problema troppo tardi.
Monitoraggio e log: dati diversi, stessa diagnosi
Le metriche mostrano che qualcosa cambia. I log aiutano a capire perché. Se la latenza di un’applicazione aumenta, le metriche possono evidenziare il momento e l’intensità del rallentamento; i log di Nginx, Laravel, Node.js o database possono rivelare query lente, errori di integrazione o eccezioni ripetute.
Per questo la raccolta dei log va progettata insieme al monitoraggio. Non è necessario conservare tutto indefinitamente, ma è necessario centralizzare gli eventi utili e definire tempi di conservazione proporzionati a esigenze operative, sicurezza e compliance. I log devono essere protetti da accessi non autorizzati e da modifiche, soprattutto quando contengono riferimenti a utenti, indirizzi IP o processi sensibili.
Un’altra distinzione utile è quella tra osservabilità tecnica e sicurezza. Un numero insolito di errori di login, richieste anomale a endpoint amministrativi o processi inattesi può essere un problema di performance, ma anche un indicatore di attacco. Collegare monitoring, analisi log e procedure di remediation permette di evitare che segnali deboli restino isolati.
Come introdurre il monitoraggio senza complicare tutto
Conviene partire dai servizi che fermerebbero l’operatività aziendale: sito e-commerce, gestionale, database, posta transazionale, integrazioni con ERP o corrieri. Per ciascuno occorre definire disponibilità attesa, metriche rilevanti, soglie, destinatari dell’alert e procedura di risposta.
Successivamente si aggiungono i controlli di capacità e prevenzione: crescita del disco, stato dei backup, certificati in scadenza, consumo memoria, tempi delle code e successo dei task schedulati. In questa fase è normale rivedere le soglie. Le prime settimane di dati servono a distinguere un comportamento normale da una deviazione reale.
Le dashboard hanno valore se supportano decisioni pratiche. Un responsabile IT può aver bisogno di vedere disponibilità, incidenti aperti e tendenze di capacità. Chi gestisce l’applicazione deve poter correlare release, errori e tempi di risposta. Il management, invece, ha bisogno di indicatori sintetici sulla continuità del servizio, non di cinquanta grafici di sistema.
Quando codice, server e sicurezza sono gestiti da soggetti diversi, il monitoraggio tende a spezzarsi: chi sviluppa non vede l’infrastruttura, chi amministra il server non conosce le priorità applicative. Un presidio unico riduce questo passaggio di responsabilità e accelera la diagnosi. È l’approccio che Noventra applica nella gestione di infrastrutture e applicazioni: misurare ciò che incide sul servizio, non collezionare metriche.
Un sistema di monitoraggio ben configurato non elimina i guasti. Riduce il tempo in cui un guasto resta invisibile e fornisce dati per intervenire con ordine. Per una PMI, questa differenza si traduce spesso in meno interruzioni, decisioni tecniche più fondate e maggiore continuità nel lavoro quotidiano.
Continua a leggere
Guida sicurezza API REST per sistemi aziendali
Guida sicurezza API REST: autenticazione, autorizzazioni, validazione e monitoraggio per proteggere dati e servizi aziendali senza rallentare sviluppo.
Integrazione applicativa aziendale efficace
Integrazione applicativa aziendale: criteri, architetture e controlli per collegare gestionali, e-commerce e servizi senza creare nuovi rischi operativi.
Software gestionale: quando il su misura serve
Software gestionale: criteri tecnici per scegliere una soluzione che semplifica processi, integra dati, protegge l operatività e resta evolutiva nel tempo.